 当122B模型跑进桌面主机:2026云栖大会解读江波龙的端侧AI存储方案
 Amelia
当大模型从云端继续往PC、AI Box和边缘设备下沉,端侧AI面临的问题也开始变得具体:模型能不能装得下,数据能不能及时喂给CPU、GPU和NPU,以及有限的内存容量能不能撑住越来越长的上下文。2026云栖大会上,江波龙把这些问题直接摆到了展台上。
江波龙以“端侧AI存储 集成应用”为主题,带来了XP2380MA AISSD™、AIDIMM™、AILPBGA™等产品,并通过本地大模型实际运行展示存储与内存方案如何参与端侧AI推理。相比单纯比拼容量和顺序读写速度,这次展出的重点更像是在回答一个问题:当AI模型真正进入本地设备,存储应该怎么跟着变。
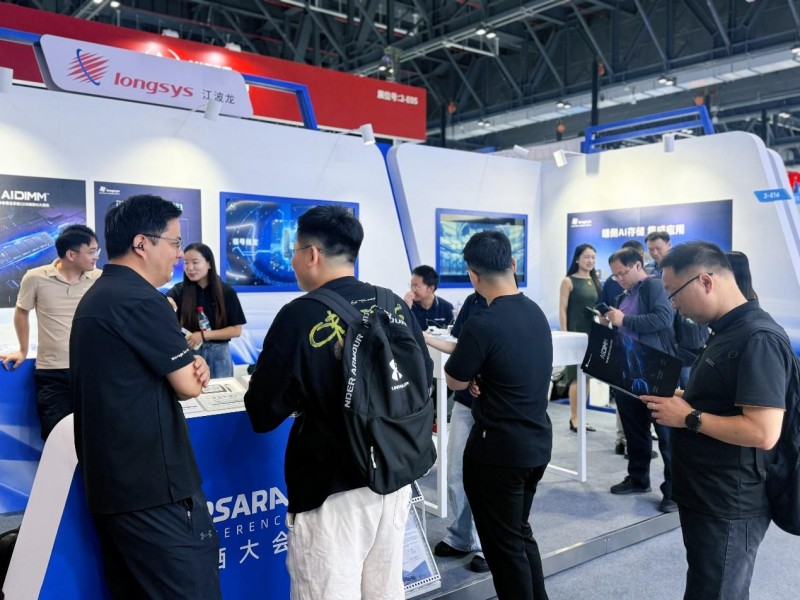
江波龙集中展示内存、SSD与软件协同方案
AIDIMM™:端侧大模型先要解决“内存墙”
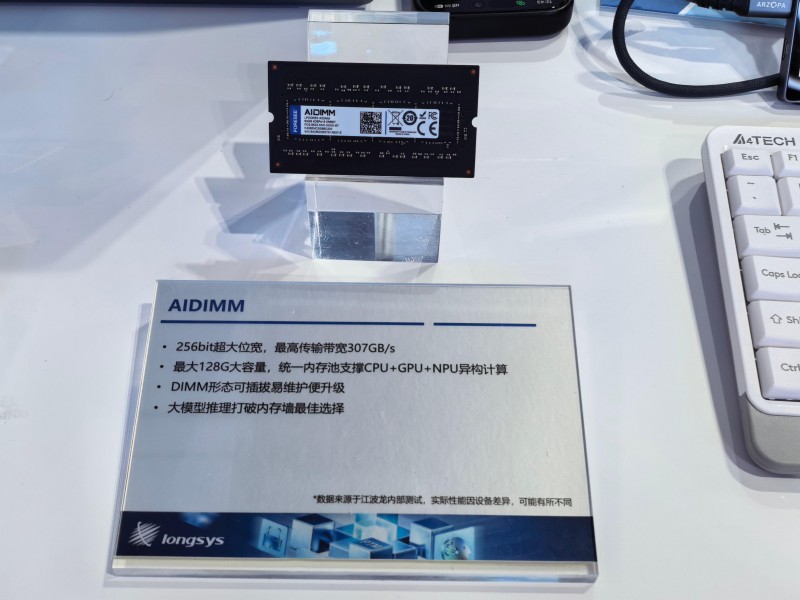
现场最显眼的新品之一是这全球首款的AIDIMM™,展牌给出的核心参数很直接:256bit位宽、最高307.2GB/s传输带宽、最大128GB容量,并采用可插拔DIMM形态。江波龙公开资料显示,这款产品面向 AI PC、智能体主机等端侧 AI 设备,旨在在大容量与高带宽之间实现新的平衡。
传统PC内存体系更强调通用性,但AI PC本地大模型推理对内存容量和带宽都更敏感。模型参数、KV Cache以及CPU、GPU、NPU之间的数据交换,会让内存很快从“够不够大”变成“够不够快”。AIDIMM™采用LPDDR5X与256bit大位宽设计,最高128GB容量,同时保留模块化、可插拔的形态,这也是它区别于CAMM形态内存方案的一点。
江波龙此前公布的信息显示,AIDIMM™单条可支持122B级以上端侧模型运行;而本次云栖大会现场的联合方案又把展示规模继续往上推。需要说明的是,现场演示界面显示的是经过量化的Qwen3.5-122B-A10B模型,因此更准确的理解是:江波龙在展示122B参数规模模型经过量化后在本地平台上的运行能力,而不是简单把“122B”直接等同于传统全精度模型所需的内存规模。
AISSD™不只追求跑分,还要替内存分担压力
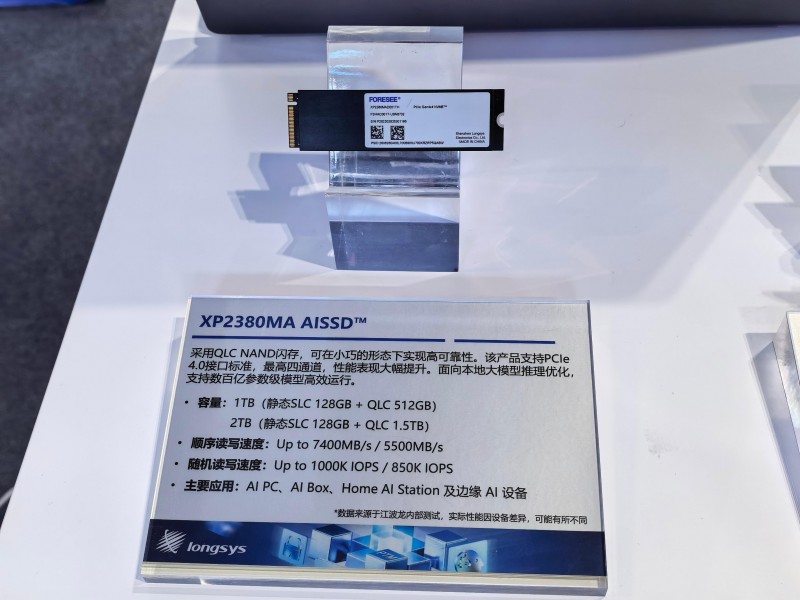
与AIDIMM™放在一起展示的XP2380MA AISSD™,则代表另一条思路:让SSD承担更多AI工作负载。现场展牌显示,这款产品采用QLC NAND,支持PCIe 4.0,提供1TB和2TB方案,顺序读取最高7400MB/s、顺序写入最高5500MB/s,随机读写最高1000K/850K IOPS,应用方向包括AI PC、AI Box、Home AI Station和边缘AI设备。
值得关注的地方并不只是读写性能。江波龙在端侧AI方案中提出通过存储智能体和系统级调度,让SSD承接一部分原本高度依赖DRAM的温冷数据与KV Cache压力。这样做并不能让NAND变成DRAM,但如果软件能够把不同热度的数据合理分层,就有机会在成本、容量与响应速度之间重新做取舍。
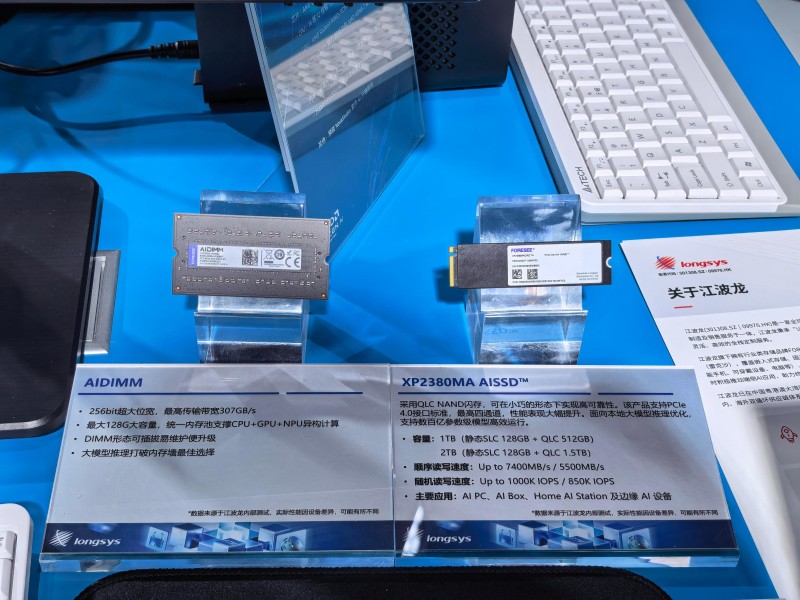
现场还能看到XP2380MA AISSD™与AIDIMM™并排工作的演示平台,软件界面会实时显示CPU、GPU和RAM占用情况。相比把SSD单独放在玻璃柜里,这种“模型跑起来给你看”的展示方式,更能说明江波龙这次想讲的并非传统标准存储产品,而是存储介质、内存和软件调度之间的协同。
江波龙此次展示的另一层内容,是iSA™存储智能体。品牌资料显示,现场方案基于AMD锐龙AI MAX+ 395平台,结合AIDIMM™与AISSD™运行本地大模型,并围绕超长上下文、MoE专家管理、KV Cache等环节进行优化。现场iSA™ Studio界面中,也可以看到本地模型、Runtime以及CPU/GPU/RAM实时资源状态。
这背后的变化是,存储厂商开始从“提供硬件”往系统层走。过去用户购买SSD,最容易比较的是容量、接口和读写速度;到了端侧AI场景,单个器件的峰值性能并不能完全决定模型体验。模型如何加载、缓存如何分层、内存和NAND怎样协同,以及不同算力单元如何调用数据,都会直接影响首Token时间和持续推理效率。
这也是江波龙强调“集成存储”的原因。硬件仍然是底座,但真正拉开差异的部分,越来越可能出现在主控、固件、封装、软件和系统级适配之间。
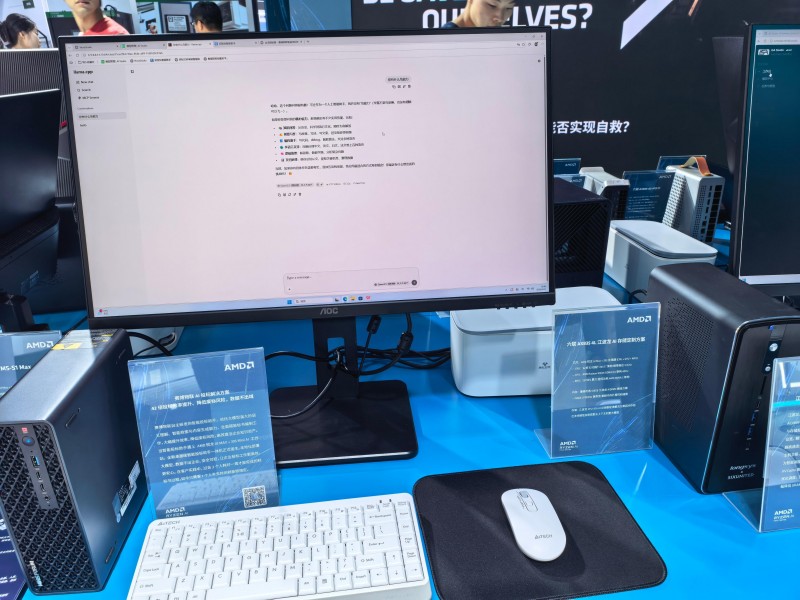
江波龙端侧AI方案进行本地模型实机演示
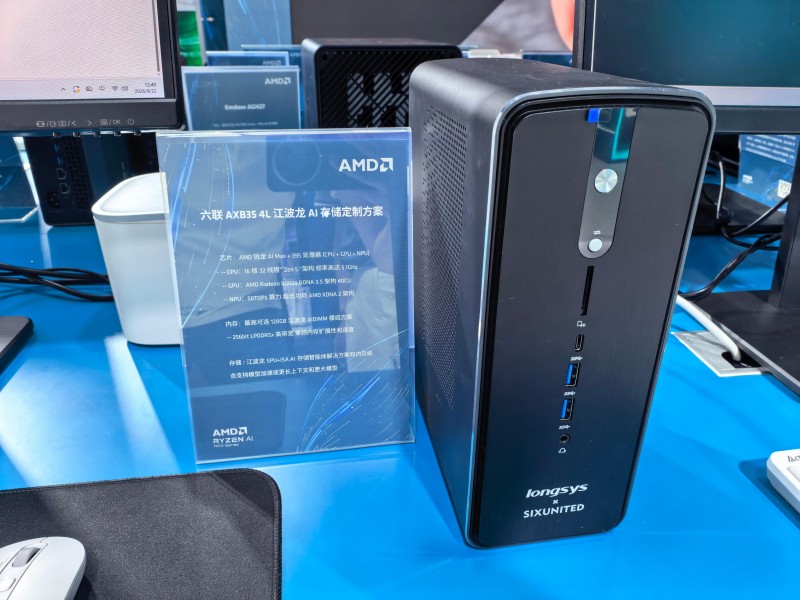
六联AXB35 4L智能体主机搭载江波龙端侧AI存储方案
热点科技洞察:AI时代,存储正在从“容量配角”变成系统变量
AI算力讨论过去很容易集中在CPU、GPU和NPU上,但当模型真正落到端侧,存储和内存的重要性会迅速上升。原因并不复杂:算力再强,如果模型装不下、数据搬不动,或者KV Cache持续挤占内存,最终体验依旧会卡在数据这一侧。
江波龙这次在云栖大会展示AIDIMM™、XP2380MA AISSD™和iSA™,比较有意思的地方就在于它没有把三者割裂开来。AIDIMM™解决高带宽、大容量内存的问题,XP2380MA AISSD™尝试用更大的NAND空间承接部分数据压力,iSA™则负责软件层面的调度与协同。三者放到一起,才构成一套更完整的端侧AI存储叙事。
当然,这条路线最终能否大规模进入消费级AI PC和智能体主机,还要看整机平台支持、软件生态、实际模型负载、成本以及长期稳定性。尤其是SSD参与缓存之后,延迟、写入放大和耐久性如何平衡,都需要真实应用继续验证。但可以确定的是,端侧AI正在改变存储行业过去以容量和接口代际为主的升级节奏。未来用户讨论一台AI设备时,除了TOPS和模型参数,内存带宽、可用容量以及数据调度方式,很可能也会成为越来越重要的指标。


 沪公网安备 31010702005758号
发表评论注册|登录