 从1.68万颗LPO到十万卡网络:锐捷在云栖大会展示的不只是更快的交换机
 Amelia
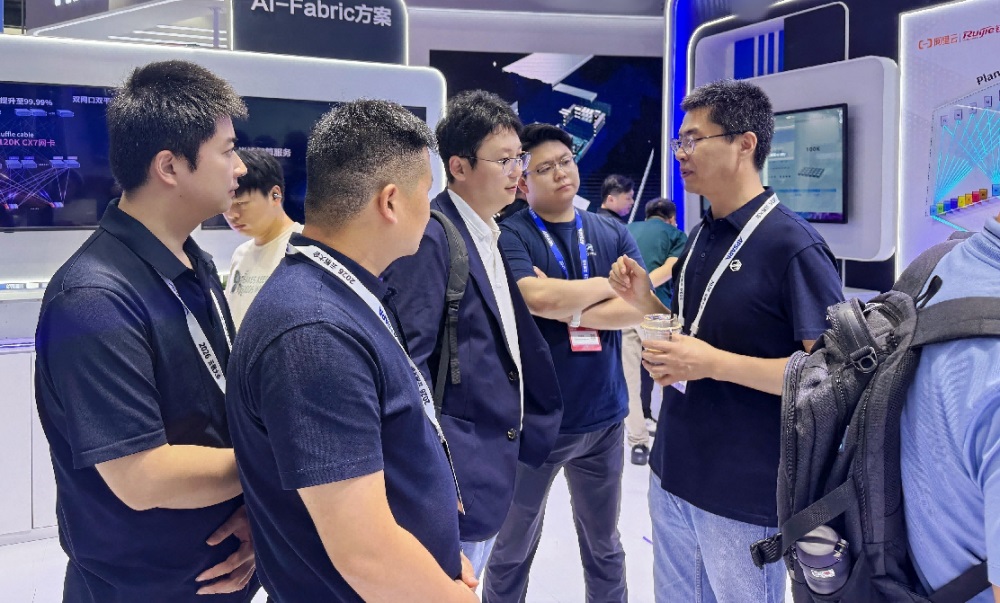
2026云栖大会走进锐捷展区最醒目的并不是某一台交换机,而是背板上“CPN2.0十万卡智算集群网络”几个字。架构图、102T级交换设备、800G与1.6T光模块、Shuffle Cable和近封装连接器被放在同一条参观动线上,指向同一个问题:当GPU集群从千卡、万卡继续扩张,网络还能不能把这些昂贵的计算资源稳定地组织起来?

这个问题比“端口速率提升了多少”更难回答。大模型训练大量依赖All-Reduce等集合通信,计算节点需要反复交换梯度和参数。一次通信只要有一条链路拥塞、一个节点变慢,其他GPU就可能进入等待。集群越大,长尾时延、链路故障和流量冲突被放大的概率越高。账面上的GPU数量,并不自动等于可以持续利用的算力。
十万卡架构,先把网络层级和流量路径压下来
锐捷在现场展示的CPN2.0方案给出了几项关键设计:800G/1.6T接入、102T商用交换机、两层Clos架构1:1收敛,以及多轨道、多平面组网。这几项参数并不是彼此孤立的卖点,它们共同服务于更少的转发层级、更充足的双向带宽和更可控的故障域。

两层Clos的价值在于减少跳数,高端口密度的102T级交换芯片让更大规模的节点可以在较少层级内完成互联,少一层交换,意味着少一段排队、转发和光电转换路径。1:1收敛则强调上下行带宽对等,避免在集合通信集中爆发时,骨干链路先成为瓶颈。
多轨道更接近GPU服务器内部的网卡和加速卡拓扑:把具有亲和关系的网卡接入对应网络轨道,可以减少跨轨绕行。多平面则把流量分散到相对独立的网络中,一方面增加并行带宽,另一方面缩小单点故障的影响范围。真正决定效果的还有负载均衡、拥塞控制、故障切换和端网协同;如果流量仍集中在少数路径上,再宽的总带宽也可能出现局部“堵车”。
从方案走向工程,1.68万颗LPO更值得细看
十万卡仍是面向未来的架构展示,锐捷与阿里云在CPN1.0中的既有部署,则提供了一组更接近工程现场的参照。据锐捷公开资料,某大规模智算集群单项目部署了1.68万颗400G LPO光模块,从上电到验收用时4天;与传统DSP光模块相比,项目实测误码率降低两个量级、单端口时延减少50ns、功耗降低50%。这些数据来自厂商项目披露,适用边界仍取决于设备、链路和测试条件。
其中更有含金量的部分,是“1.68万颗”和“4天”。LPO去掉模块内部负责信号恢复与均衡的DSP,可以降低功耗和时延,但也把更多信号完整性压力交给交换芯片SerDes、主板走线和整机调校。实验室里跑通一条链路,与上万只模块在同一项目中完成批量上线,是两个不同层级的问题,后者还要面对器件一致性、温度、插损、布线和验收效率。
锐捷与阿里云在OFC 2026发表的论文进一步触及这一难点:研究针对插入损耗超过39dB的102.4Tbps交换机建立线性链路模型,并完成LPO适配验证。它透露出的行业变化很清楚——到了800G和1.6T时代,光模块不能再被当作独立配件,交换ASIC、PCB、连接器、光引擎和算法需要一起设计。厂商竞争也由单品参数,逐渐转向整机和链路级的联合优化能力。
LPO、LRO、NPO/CPO不是简单的代际替换
现场展台同时摆出了800G LPO 2DR4、800G LPO DR8、800G LRO、1.6T LPO和1.6T LRO。这样的组合比只展示最高速率更有信息量,因为下一代光互联目前仍处于多条技术路线并行推进的阶段。
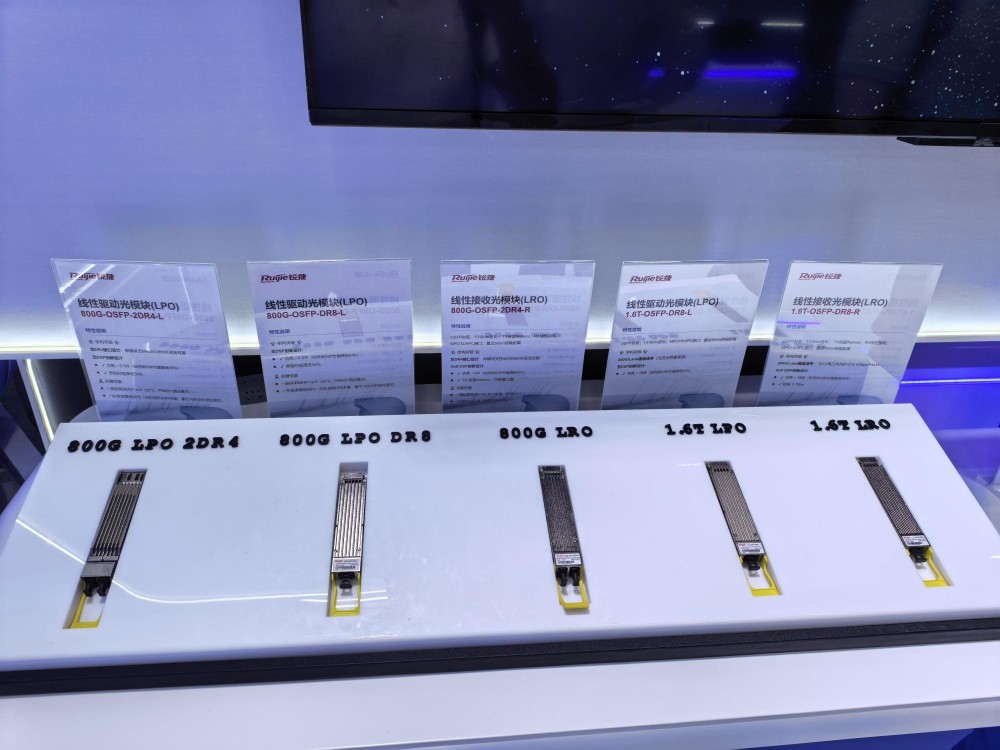
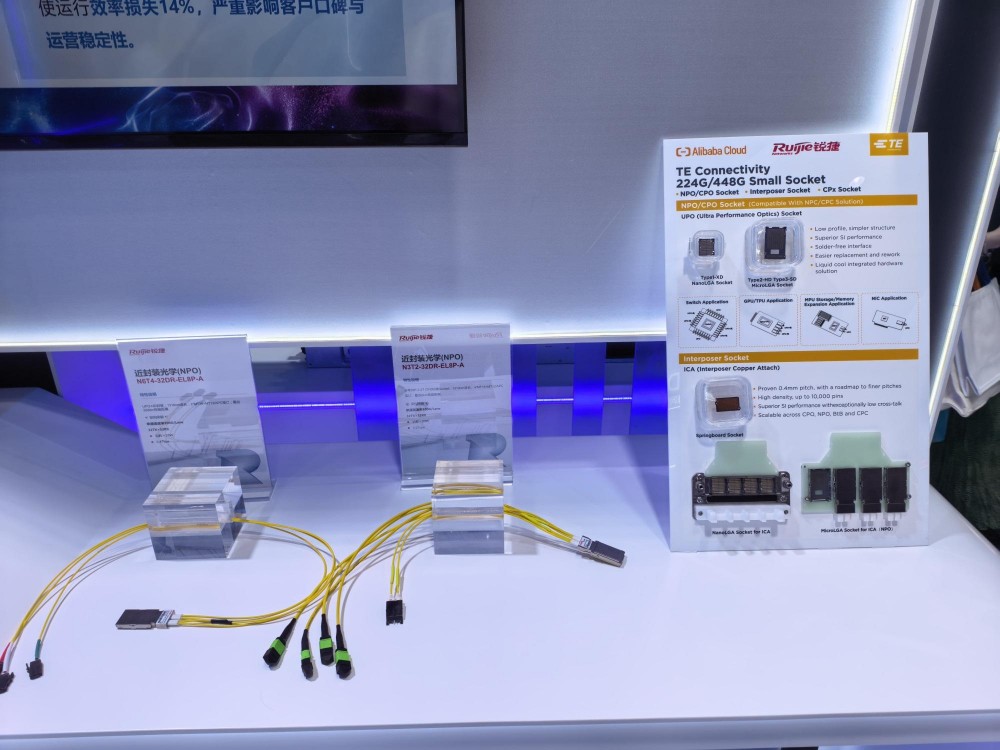
LPO把模块中的DSP拿掉,保留传统可插拔形态,功耗、时延和成本更有优势,维护方式也较熟悉;代价是链路预算更紧,对主机侧SerDes和系统调校要求更高。LRO只在线性接收侧简化处理,发送侧保留重定时能力,在能耗与互操作性之间寻找折中。NPO和CPO进一步把光引擎放到交换芯片附近,用更短的电连接换取更高带宽密度和能效,但散热、封装、光纤管理以及故障后的维护方式都需要重新设计。
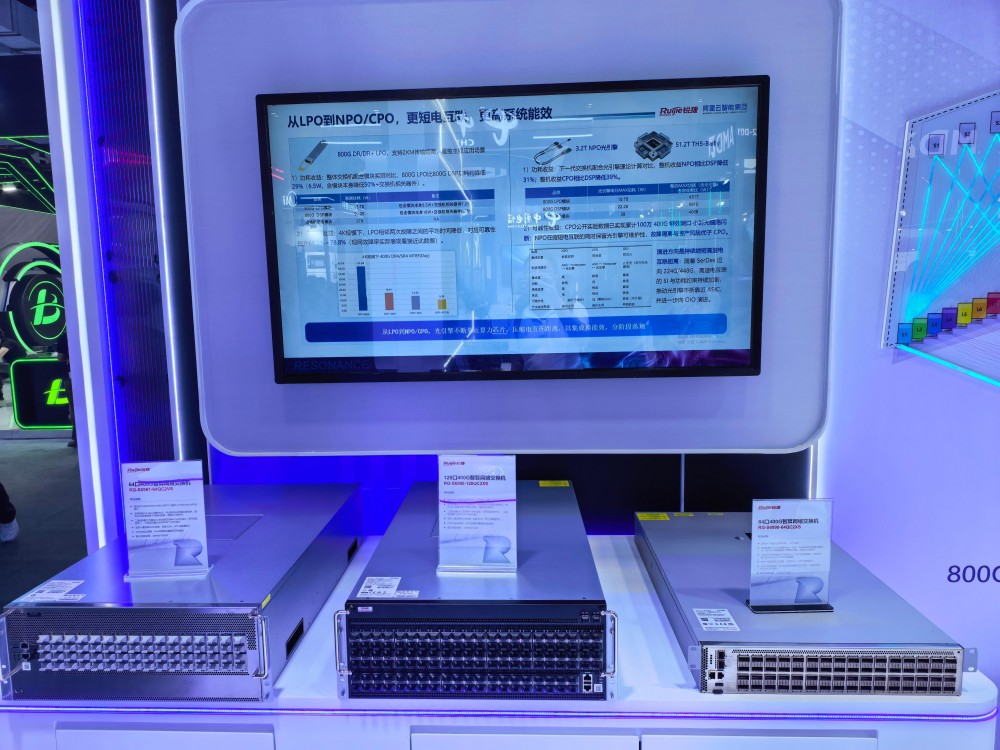
因此,从LPO一路走到NPO/CPO,并不是后一种技术立即淘汰前一种。不同链路距离、端口密度、维护要求和部署节奏,会对应不同选择。锐捷在展区同时摆出多条路线,反映的是网络设备厂商需要为客户保留演进空间:当前可以用可插拔方案规模交付,后续在102.4T乃至更高容量平台上,再根据系统条件把光引擎向芯片靠近。
线缆和连接器,也开始进入算力效率的账本
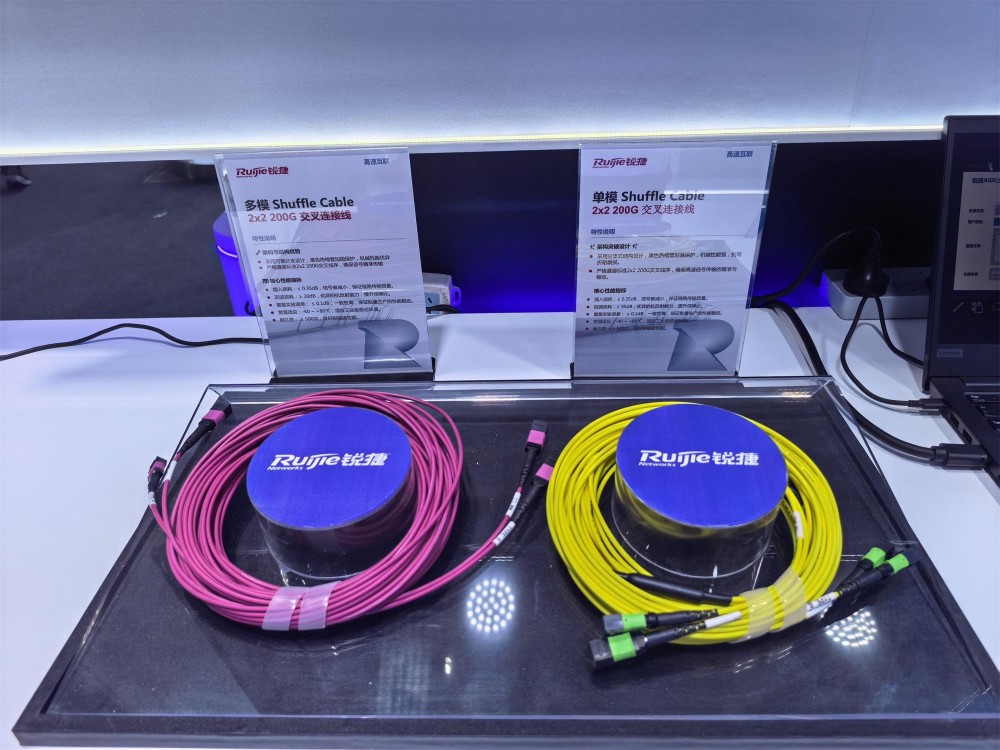
展区里两卷粉色、黄色Shuffle Cable很容易被当作配角。实际上,十万卡网络的复杂度不仅在交换芯片里,也体现在机柜之间成千上万条物理连接上。交叉连接线把特定的端口映射预先固化,可以减少现场跳接和配线错误,让多轨、多平面的拓扑更容易按设计落地。
旁边的NPO连接方案、TE Connectivity 224G/448G小型插座,则对应更短电连接和更高通道速率。速率提高后,PCB上每一段走线、每一个连接器都会消耗信号预算。把光电转换向交换芯片靠近,能够缩短高频电信号传输距离,但同时会把装配、散热与维护问题推到系统设计环节。
这也解释了为什么锐捷把交换机、光模块、线缆和连接器放在一起展示。对大规模智算中心而言,物理层已经不是采购清单末尾的辅材,而是影响交付速度、链路可靠性、扩容效率和故障定位时间的一部分。
热点科技洞察:网络厂商的价值正在从供货延伸到系统协同
从AIDC、DCI到光电融合和CPN2.0,锐捷这次展示的主线可以概括为两层:数据中心内部要提高GPU之间的通信效率,数据中心之间则要让算力资源能够跨地域调度。前者解决“一个集群怎样跑得更满”,后者解决“多个资源池怎样协同”。当模型训练、推理和数据处理分布在不同区域,两者最终会汇合为一套端到端的网络能力。
更深一层看,AI基础设施的采购逻辑也在改变。客户真正购买的并非某个端口的峰值速率,而是一段时间内可持续交付的训练吞吐。交换机带宽、集合通信效率、尾时延、误码率、故障收敛时间、每Tbps功耗、批量上线周期和平均修复时间,都应当进入同一张评估表。只有这些指标共同稳定,峰值算力才有机会转化为有效算力。
这正是锐捷此次展出的信息密度所在。CPN2.0勾勒出十万卡级网络的扩展方向,CPN1.0的LPO项目则提供了规模交付的工程样本,800G/1.6T与NPO/CPO相关展品补上后续演进路线。不过,方案图和厂商数据仍只是判断的一部分。对计划建设大规模GPU集群的客户而言,下一步更值得追问的是:在真实模型、真实流量和长期运行条件下,网络能否保持稳定吞吐;发生局部故障时,训练任务需要多久恢复;不同代际设备又能否平滑共存。
AI集群的竞争已经从“买到多少芯片”,走向“能否把芯片持续用好”。当计算节点扩张到十万卡量级,网络不再只是连接算力的通道,而是决定算力利用率、能耗和交付节奏的系统变量。锐捷在云栖大会给出的答案,是用更少层级的Clos架构、多轨多平面组网,以及从可插拔光模块到近封装光学的完整路径,把网络重新放回智算系统设计的中心。


 沪公网安备 31010702005758号
发表评论注册|登录